实测测评 · 音频降噪 · FIELD GUIDE
街访录音降噪实测:20 秒原声与处理结果对比
我们用 QuietTake 网页工具处理一段真实公开的维修现场采访录音。处理后综合响度低了 1.2 LU,时长和编码规格保持一致;这能说明输出变化,却不能单凭一个数字证明语音更清楚。
公开的 E-3 Sentry 维修现场采访音频,单声道 AAC,48 kHz。
同一时间段由 QuietTake 网页工具的强力预设处理。没有做响度匹配,听感对比时请留意两轨音量不同。
这次要回答什么
降噪样片很容易做成宣传片:选一段最明显的噪声,调大处理后音量,再让人快速切换 A/B。这样的展示适合发现“噪声有没有少”,却容易把“更响”误听成“更好”。这次我们保留同一段素材、同一时间范围和原有输出电平,先公布能复核的文件信息,再说明听感判断的边界。
对象是一段公开发布的 E-3 Sentry 维修与访谈视频。我们截取其中同一段 20 秒采访音频,分别保留原声和经 QuietTake 网页工具处理的版本。上面的播放器可以直接来回试听。两条轨道没有做响度匹配,因此它不是盲听实验,也不是“多少人更喜欢处理版”的调查。
**先给结论:**处理版的综合响度低了 1.2 LU,文件仍是 20 秒、48 kHz、单声道 AAC。噪声减少可能同时带走一部分总能量,所以较安静本身既不能证明处理失败,也不能证明语音更清楚。判断要回到原音和具体词句。
样本与处理方法
源视频由美国国防视觉信息发布机构 DVIDS 发布,页面标注 Public Domain。样片说明记录了作者、来源和素材用法;公开来源不代表 DVIDS 或采访对象为 QuietTake 背书。我们从源片第 190 秒附近准备 30 秒工作片段,留出模型预热区,再截取随后 20 秒作为 A/B 播放样本。网页工具用实际降噪流程和强力预设生成处理轨,之后把两轨编码为相同的 AAC 输出规格。
输出规格:20.000 秒、AAC-LC、48 kHz、单声道。我们没有分别调 EQ、压缩、响度或动态范围,也没有给处理版补音量。保留这个差异是为了让播放器呈现真实导出,而不是一条经过后期“听起来更讨喜”的版本。
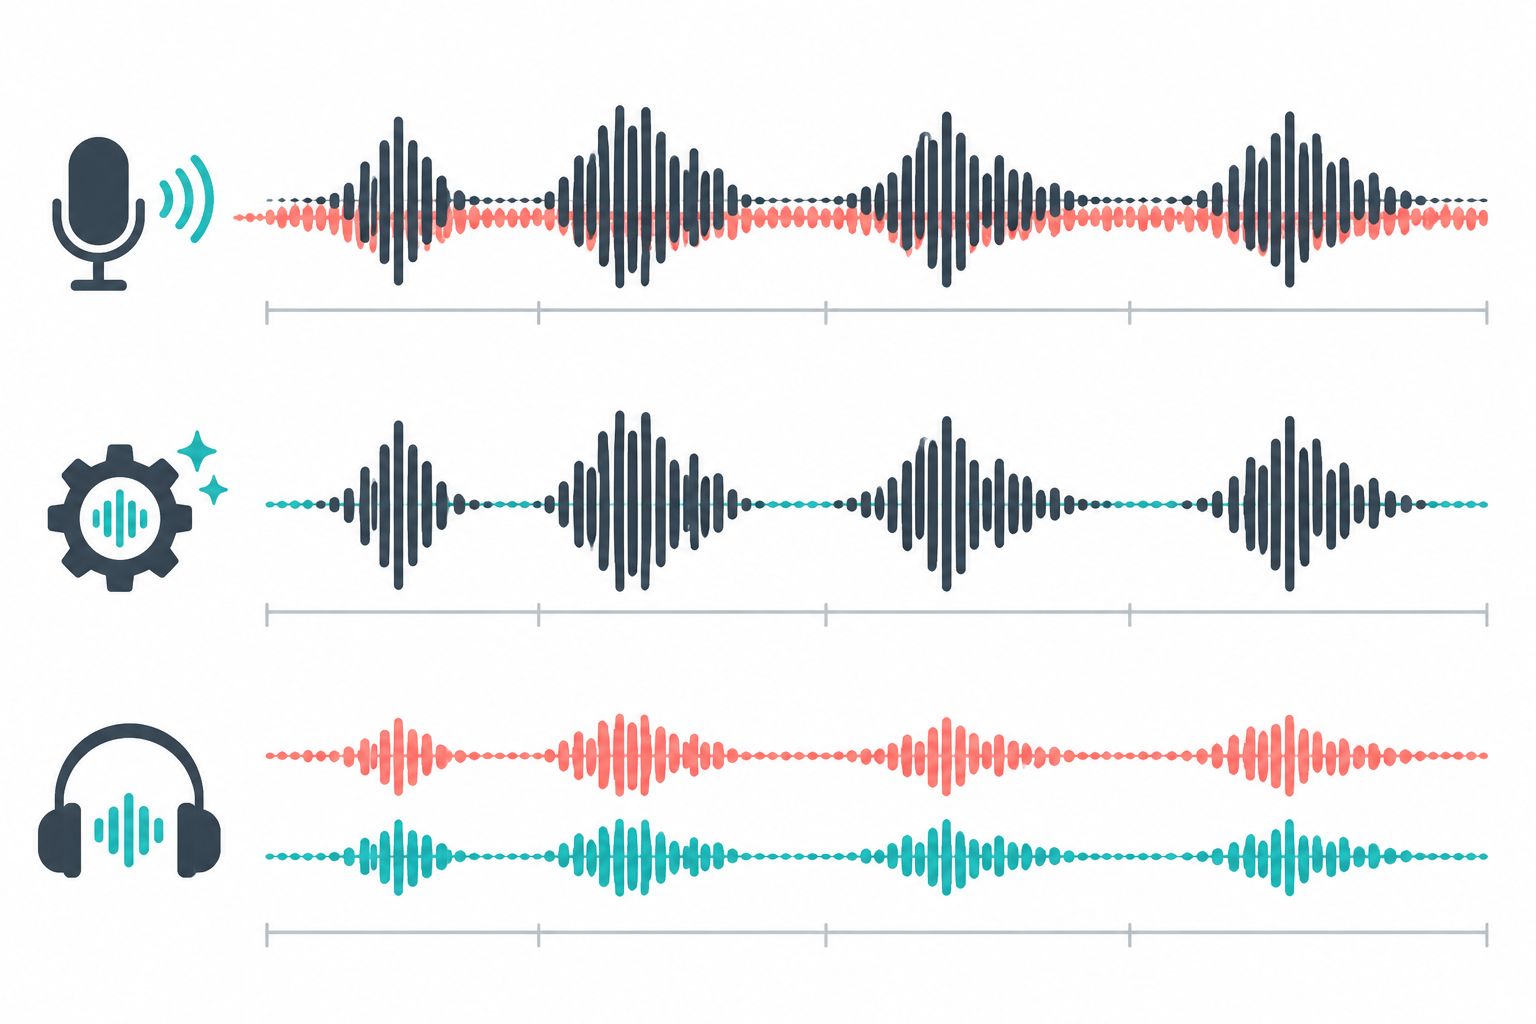
这张图解释复听思路,不是上述 20 秒片段的频谱或噪声测量。图中看起来更简单的波形也不等同于更好的语音。请用播放器听同一处的辅音、人名、句尾、呼吸和短暂停顿。
可复核的文件结果
下表的响度由 FFmpeg ebur128 对两份 20 秒 AAC 文件测得。文件大小直接读取最终样片,不将编码差异解释成音质差异。
| 项目 | 原始录音 | 降噪录音 | 差值 |
|---|---|---|---|
| 时长 | 20.000 秒 | 20.000 秒 | 相同 |
| 编码 / 采样率 / 声道 | AAC-LC / 48 kHz / 单声道 | AAC-LC / 48 kHz / 单声道 | 规格相同 |
| 综合响度 | −17.4 LUFS | −18.6 LUFS | 低 1.2 LU |
| 文件大小 | 329,896 字节 | 336,220 字节 | 多 6,324 字节,约 1.9% |
LUFS 是整个片段的综合响度估计,不是背景噪声电平,也不是语音清晰度分数。文件略大只说明这次 AAC 编码产物字节不同,不能推出它质量更高或更低。这个片段的压缩器、现场风声与设备声也不能代表所有街访录音。
听 A/B 时检查什么
先完整听原版,选一句包含短词和句尾的回答,再切换到处理版听同一位置。音量尽量保持不变,不要只在头两秒快速来回点击。暂停或转场时听背景底色有没有明显抽动;说话时听清楚辅音和名字是否保留;句尾要检查弱音有没有被吞掉;呼吸、衣物摩擦和现场环境声则要判断是否自然。
如果处理后背景音少了,但说话声变薄、发水声、断续或金属感更明显,说明不能只追求最安静。可以换更温和的强度、缩短测试区间,或接受保留少量稳定环境声。强力预设可能对某个噪声类型有帮助,也可能让另一个录音失去自然感。
我们的页面提供前后试听,完整流程从本机媒体开始。打开音频降噪工具,用你自己的短片段试听,再决定是否处理完整录音。先保留原件,满意后另存结果;不要用样片结果推断你设备上的速度或所有素材都能得到相同改善。
这次测评没有证明什么
这是一段素材的一次网页处理,不是多设备性能测试、用户偏好调查或模型排行榜。没有干净的同场景录音作为目标真值,因此我们不能计算“原声恢复准确率”,也没有在多人盲听下测量可懂度。响度差 −1.2 LU 是真实可重复的结果,但它无法单独告诉我们哪些背景频段下降、哪些语音细节改变。
样片来自公开的视频,录音距离、麦克风、风向、采访对象和维修现场都固定在这一条素材里。另一个手机、领夹麦、室内混响、音乐背景或多人重叠会给模型带来不同挑战。严重削波、完全被发动机覆盖的语音、彼此重叠的说话人,都可能无法从现有信息中恢复。
降噪服务和浏览器兼容性也可能随版本变化。本页保留的是当前仓库中已有的样片和当时处理轨,不等于一个新设备上的性能承诺。若要评估批量或关键内容,应该用同一批许可素材、固定设置、多设备、盲听和语音可懂度测试重新验证。
适合怎样使用
- 录音有持续空调、风扇或道路声,但人声仍能辨认:先用短区间测试,再比较音色和弱词。
- 只在个别时刻出现喇叭、碰麦或大声人群:考虑剪辑、局部处理或重录,不一定要全片套同一强度。
- 人声被噪声完全盖住或已经削波:保留原始文件,找备用麦克风或相机音轨;不要期待工具补回未录到的细节。
- 采访要公开:除了背景噪声,也检查个人信息、授权范围、字幕和导出格式。
数据与素材说明
数据来自 QuietTake 现有首页 A/B 样片,源视频及版权信息见 素材记录。20 秒音频由 street-interview-original.m4a 和 street-interview-cleaned.m4a 提供。响度测量使用 FFmpeg ebur128,文件属性使用 FFprobe 检查。数值描述这两个文件,不外推到其他录音。
怎样复核这次 A/B
如果要检查播放器里的听感,先选一句原声中有连续语句的地方,不要只挑开头最响的一声。重复播放时保持电脑和播放器音量不变,先听原声,再听处理版,之后短暂休息再反向重复。人耳会很快适应持续噪声;间隔一次更容易发现语音质感改变。也可以让另一位听者在不知道版本顺序时写下听到的词,再比对他是否漏掉辅音、人名或语气词。这只是小范围复核,不等于正式盲测。
同一片段最好分成三类问题记录:第一,语言信息是否完整,特别是数字、短词和句尾;第二,背景音是否变得稳定,还是出现抽吸、忽大忽小或断续;第三,音色是否仍像同一个说话人。若要报告结果,可以保留每位听者的逐句记录、片段起止时间和播放顺序,不要只写“听起来干净不少”。此处没有完成多人听测,因此不能替读者填写偏好结果。
这份样片的原声比处理声响 1.2 LU。若先把处理版调大到相同响度,有些人会觉得它更清楚;若未经调整直接比较,也可能因为较小而误以为较差。两种情况都说明音量是一个会影响感知的变量。测评采用未匹配响度的真实导出,是为了让人看到产品实际文件;读者自行试听时,可以同时注意音量差,而不是把它隐藏起来。
若你要测试自己的素材,可复制一份文件并选择包含人声、停顿和背景声的 10–30 秒。只改一个处理设置,重新导出后用同一设备、同一音量和同一时间点比较。记录采样率、声道、长度以及是否做过归一化。这样无法证明工具对所有音频都更好,但能避免把不同片段或不同音量造成的差异错算成模型效果。
何时不应继续加大降噪
声音里有持续的低频轰鸣时,强力模式可能让背景更安静,但也可能压低低沉的人声和呼吸声。多位说话人同时讲话时,模型可能把次要发言当作背景。演讲、音乐、环境声和语言声叠在一起时,还应确认处理是否符合内容用途。工具针对的是清理背景,不是分离每一个人的声道,也不会自动修复回声、削波或缺失的音节。
如果强力预设不自然,尝试更轻的设置,或先缩小处理区间,再回到完整素材复核。若仍有问题,保留原音、减少处理,或者剪去一段干扰明显的时间。新闻、采访、教学和法律记录等内容要特别谨慎:处理前后都保留文件,记录使用的设置,并让熟悉内容的人检查引语和数字。清晰度改善不能取代内容核验。
一个有用的测评结论应说明“在这段样片和这些检查条件下观察到了什么”,而不是预测每个用户的结果。本文给出实测响度和格式,是因为它们可重复、易核对;语音是否更易懂则需要针对实际片段进行听测。下方工具入口可以用来做自己的 A/B,但最终保留处理版还是原版,应由你检查过的实际用途和输出质量决定。
为避免把这次样片误当成通用答案,我们还应说明哪些变化会让结果失效。上传平台可能会再次压缩声音,手机扬声器也会掩盖细微齿音;耳机、房间声和播放音量不同,都可能改变听者的判断。如果要在团队里讨论同一段素材,应先统一播放设备、音量和时间范围,并让听者记录具体听不清的词,而不是只给出“更干净”这样的整体印象。
不同用途的判断重点也不一样。播客可能更重视连续听感,新闻采访要优先核对姓名、数字和引用,短视频则要保证环境声与画面仍然相配。本文没有对这些场景分别做测试,所以不把一个采访片段的 −1.2 LU 推广成产品承诺。最稳妥的做法是从副本开始,先试听一小段,再把实际导出放回完整内容中复核。
如果处理结果改变了关键语句的音色、吞掉句尾,或者让背景忽然抽动,先撤回到更轻的处理,而不是继续追求静音。把原声、工作副本和最终版分别保存,必要时回到录音现场寻找第二路音轨。降噪工具可以减少一部分背景干扰,是否适合发布仍需创作者检查并承担判断。
团队协作时,可以把试听时间点、处理强度和需要回听的词句写进剪辑备注,让另一位编辑能从同一位置复核。也要记录输出是否经过音量归一化、转码或平台二次压缩。不同设备的试听音量应先尽量统一,但归档样片仍要保留真实导出,不能用归一化版本冒充原始结果。
若素材包含采访对象的隐私或未公开信息,上传和试听也要符合授权范围。先确认有权使用这段内容,再决定是否交给在线处理服务;测试片段不应包含不必要的个人资料。音质改善、版权许可、采访同意和事实核验是不同问题,降噪工具不会自动解决它们。