Produkttest · Audiobereinigung · PRAXISLEITFADEN
Störgeräuschentfernung bei einem Straßeninterview im Test: 20 Sekunden im Vorher-Nachher-Vergleich
Wir haben ein öffentlich zugängliches Interview an einem Wartungsstandort mit QuietTake bearbeitet. Die integrierte Lautheit sank um 1,2 LU, während Dauer und Kodierung gleich blieben. Das beschreibt die Ausgabe; eine einzelne Zahl kann nicht belegen, dass Sprache verständlicher geworden ist.
Öffentlich zugängliche Interviewaufnahme zur Wartung der E-3 Sentry, Mono-AAC mit 48 kHz.
Derselbe Abschnitt, bearbeitet mit der starken Voreinstellung der QuietTake-Webanwendung. Die Lautheit wurde nicht angeglichen; berücksichtige beim Anhören den Pegelunterschied.
Die Frage hinter diesem Test
Demos zur Störgeräuschentfernung können leicht zu Werbeclips werden: auffällige Störgeräusche auswählen, die bearbeitete Spur lauter stellen und dann schnell zwischen A und B wechseln. Das kann zeigen, ob ein Geräusch reduziert wurde, doch eine lautere Spur kann auch besser wirken. Dieser Vergleich verwendet denselben Quellabschnitt mit den tatsächlich exportierten Pegeln und nennt zunächst messbare Dateieigenschaften, bevor er darauf eingeht, was sich durch Anhören feststellen lässt und was nicht.
Die Quelle ist ein frei zugängliches Video zur Wartung der E-3 Sentry mit einem Interview. Wir verwenden denselben 20-sekündigen Interviewabschnitt für das Original und die Ausgabe des QuietTake-Webtools. Beide Player oben lassen sich direkt abspielen. Wir haben die Lautheit der Spuren nicht angeglichen. Dies ist daher keine verblindete Hörstudie und sagt nicht aus, wie viel Prozent der Menschen die bearbeitete Version bevorzugen.
Das Ergebnis in Kürze: Die bearbeitete Spur ist laut Messung insgesamt 1,2 LU leiser. Beide Dateien sind 20 Sekunden lang und als Mono-AAC mit 48 kHz kodiert. Die Störgeräuschreduzierung kann zusammen mit den Störgeräuschen auch die gesamte Signalenergie senken. Ein niedrigerer Pegel allein belegt daher weder ein Scheitern noch verständlichere Sprache. Die Entscheidung hängt weiterhin von den tatsächlichen Wörtern und der Aufnahme ab.
Beispiel und Bearbeitung
Die Quelle wurde vom U.S. Defense Visual Information Distribution Service (DVIDS) veröffentlicht und auf der Quellseite als gemeinfrei (Public Domain) gekennzeichnet. Die Quellenangaben zu diesem Beispiel dokumentieren Urheber, Quelle und Verwendung; die Kennzeichnung als gemeinfrei bedeutet keine Unterstützung oder Empfehlung durch DVIDS oder die interviewte Person. Wir haben einen 30-sekündigen Arbeitsabschnitt nahe der Zeitmarke 190 Sekunden im Quellmaterial vorbereitet, einen Vorlauf zum Anlaufen des Modells vorgesehen und die folgenden 20 Sekunden für den Vergleich verwendet. Die bearbeitete Spur entstand im tatsächlichen Web-Arbeitsablauf von QuietTake mit der starken Voreinstellung. Anschließend wurden beide Spuren in dasselbe AAC-Ausgabeformat kodiert.
Ausgabespezifikation: 20,000 Sekunden, AAC-LC, 48 kHz, Mono. Wir haben EQ, Kompression, Lautheit oder Dynamik nicht separat verändert und die bereinigte Datei nicht verstärkt. Durch den beibehaltenen Pegelunterschied gibt der Player die exportierten Dateien wieder und keine nachbearbeitete Version, die angenehmer klingen soll.
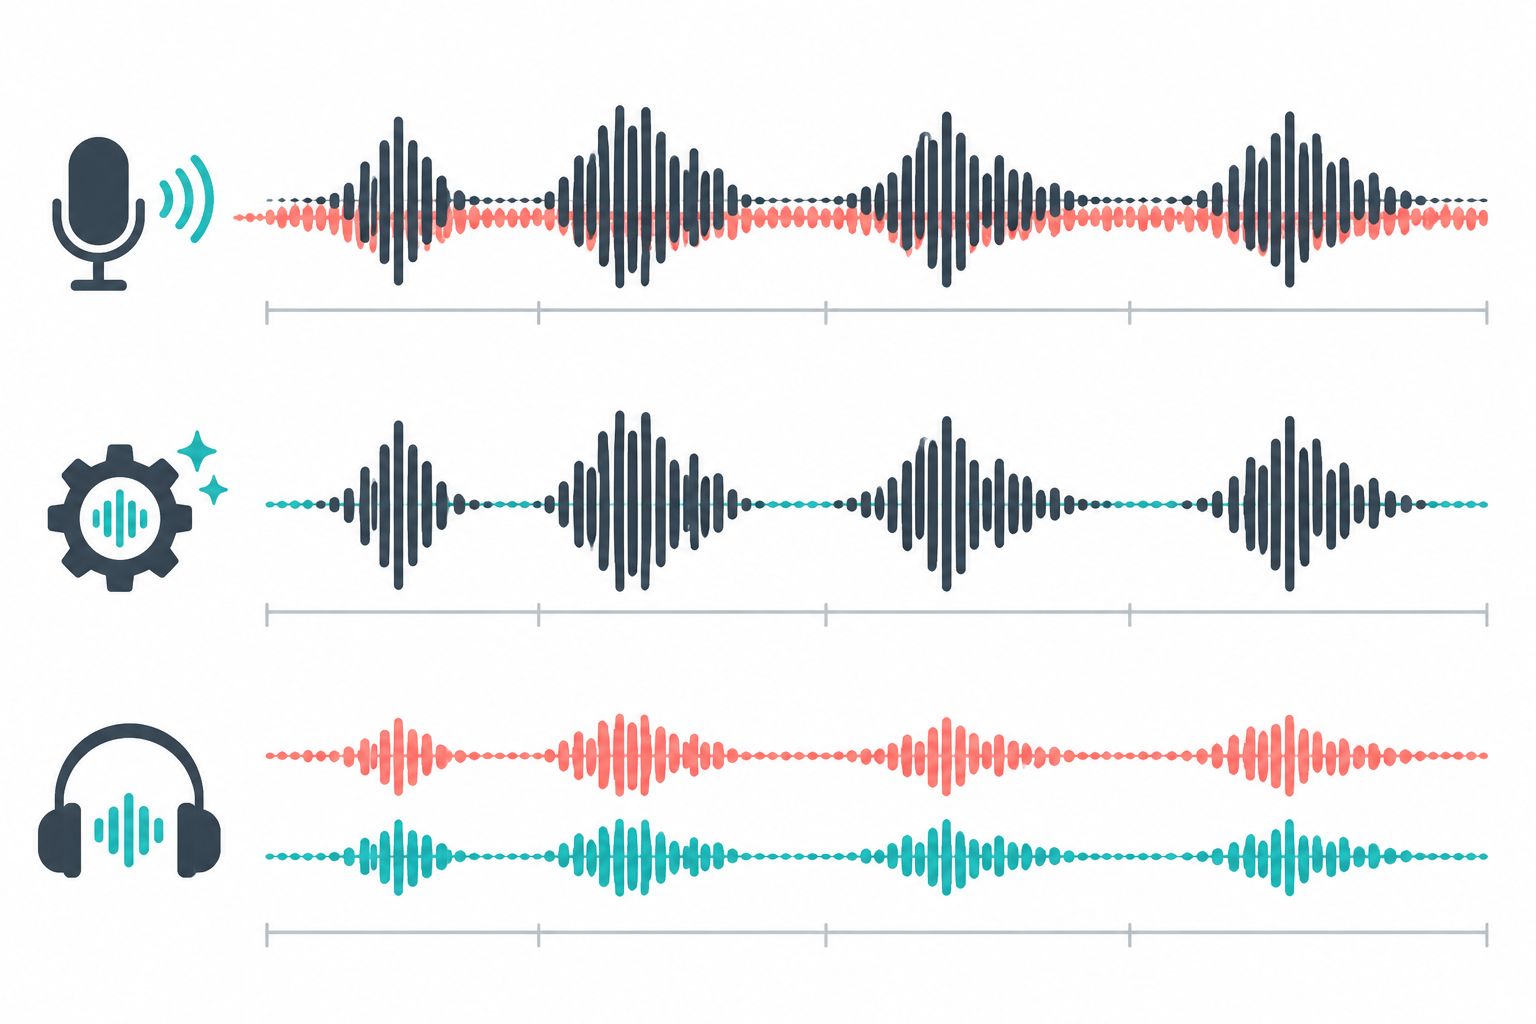
Dieses Bild erklärt den Ablauf beim Abhören; es zeigt kein Spektrum und keine Störgeräuschmessung des 20-sekündigen Clips. Eine einfacher aussehende Wellenform bedeutet nicht unbedingt verständlichere Sprache. Hör dir mit den Playern dieselben Konsonanten, Namen, Wortenden, Atemzüge und Pausen an.
Messbare Dateiergebnisse
Die integrierte Lautheit wurde für jede finale 20-sekündige AAC-Datei mit FFmpeg ebur128 gemessen. Die Dateigrößen entsprechen den tatsächlich exportierten Bytes; ihr Unterschied wird nicht als Qualitätsunterschied gewertet.
| Messgröße | Original | Störgeräusche reduziert | Unterschied |
|---|---|---|---|
| Dauer | 20,000 s | 20,000 s | Gleich |
| Codec / Abtastrate / Kanäle | AAC-LC / 48 kHz / Mono | AAC-LC / 48 kHz / Mono | Gleiches Format |
| Integrierte Lautheit | −17,4 LUFS | −18,6 LUFS | 1,2 LU niedriger |
| Dateigröße | 329.896 Bytes | 336.220 Bytes | 6.324 Bytes größer, etwa 1,9 % |
LUFS schätzt die integrierte Lautheit eines Clips. Der Wert gibt weder den Hintergrundgeräuschpegel noch die Sprachverständlichkeit an. Eine etwas größere Datei bedeutet nur, dass diese AAC-Kodierung mehr Bytes erzeugt hat; daraus lässt sich keine höhere oder niedrigere Klangtreue ableiten. Ein einzelnes Interview mit seinem spezifischen Mikrofonabstand, Wind, Equipment und seiner Raumakustik kann außerdem nicht für alle Straßenaufnahmen stehen.
Worauf du im A/B-Vergleich achten solltest
Höre dir die Originalaufnahme einmal vollständig an. Wähle dann einen Satz mit kurzen Wörtern und einem vollständigen Satzende aus und vergleiche genau diesen Abschnitt mit der bearbeiteten Version. Lass die Wiedergabelautstärke gleich und beurteile die Aufnahme nicht, indem du über die ersten zwei Sekunden hin und her springst. Achte in den Pausen auf Pumpen oder einen wechselnden Hintergrundklang. Prüfe bei der Sprache Konsonanten und Namen. Achte am Satzende darauf, dass leise Silben erhalten bleiben. Entscheide, ob Atemgeräusche, Kleiderrascheln und Umgebungsgeräusche noch natürlich klingen.
Wenn die Hintergrundgeräusche abnehmen, die Sprache aber dünn, wässrig, abgehackt oder metallisch klingt, solltest du nicht allein auf Stille abzielen. Probiere eine mildere Einstellung, einen kürzeren Abschnitt oder akzeptiere einen Teil der gleichmäßigen Umgebungsgeräusche. Eine starke Voreinstellung kann bei einer Geräuschart helfen, bei einer anderen Aufnahme aber unnatürlich klingen.
Mit dem Audio-Rauschunterdrückungstool kannst du einen kurzen Abschnitt deiner eigenen Medien ausprobieren, bevor du entscheidest, ob du die vollständige Aufnahme bearbeitest. Behalte das Original und speichere das Ergebnis separat. Leite aus diesem Beispiel weder die Geschwindigkeit auf deinem Gerät noch eine garantierte Verbesserung für alle Dateien ab.
Was dieser Test nicht belegt
Dies ist ein einzelner Quellabschnitt, der einmal mit dem Webtool bearbeitet wurde. Es handelt sich weder um einen Leistungstest auf mehreren Geräten noch um eine Umfrage zur Hörerpräferenz oder ein Modell-Ranking. Uns liegt keine saubere, gleichzeitige Aufnahme derselben Szene als Referenz vor. Daher können wir weder die Wiederherstellungsgenauigkeit berechnen noch eine gemessene Verbesserung der Sprachverständlichkeit behaupten. Das Ergebnis von −1,2 LU lässt sich anhand dieser Dateien reproduzieren, zeigt aber nicht, welche Rauschfrequenzen abgenommen oder welche Sprachdetails sich verändert haben.
Die öffentlich zugängliche Quelle legt Mikrofonabstand, Wind, interviewte Person, Equipment und Ort fest. Ein anderes Smartphone, ein Ansteckmikrofon, ein halliger Raum, Musik oder überlappende Stimmen stellen eine andere Aufgabe dar. Starke Übersteuerung, Sprache, die vollständig von einem Motor überdeckt wird, oder gleichzeitige Stimmen lassen sich aus der Aufnahme möglicherweise nicht wiederherstellen.
Auch der Workflow zur Rauschunterdrückung und die Browserunterstützung können sich mit der Zeit ändern. Diese Seite dokumentiert das vorhandene Beispielpaar und verspricht keine bestimmte Leistung auf einem neuen Gerät. Eine aussagekräftige Bewertung für den Stapelbetrieb oder kritische Anwendungen würde freigegebenes Material, feste Einstellungen, mehrere Geräte, pegelangepasstes Blindhören und eine Beurteilung der Sprachverständlichkeit erfordern.
Wann sich dieser Ablauf eignet
- Gleichmäßige Klimaanlagen-, Lüfter- oder Straßengeräusche bei verständlicher Sprache: Teste einen kurzen Abschnitt und vergleiche die Stimmklangfarbe und leisen Wörter.
- Eine Hupe, ein Stoß ans Mikrofon oder eine laute Menschenmenge an einer Stelle: Schneide den Abschnitt, bearbeite nur diesen Bereich oder nimm erneut auf, statt überall dieselbe starke Einstellung anzuwenden.
- Vollständig überdeckte oder übersteuerte Sprache: Behalte das Original und suche nach einer weiteren Mikrofon- oder Kameraspur. Erwarte nicht, dass fehlende Details wieder auftauchen.
- Ein Interview zur Veröffentlichung: Prüfe außerdem personenbezogene Informationen, Einwilligung, Untertitel und Exporteinstellungen.
Hinweise zu Daten und Beispiel
Das Audiopaar stammt aus QuietTakes bestehendem A/B-Beispiel auf der Startseite. Hinweise zur Quelle und zu den Nutzungsrechten findest du im Quellennachweis zum Beispielmaterial. Die 20 Sekunden langen Dateien heißen street-interview-original.m4a und street-interview-cleaned.m4a. Die Lautheit wurde mit FFmpeg ebur128 gemessen; die Dateieigenschaften wurden mit FFprobe geprüft. Diese Messwerte beschreiben nur diese beiden Dateien.