Test produit · Effaceur vidéo · GUIDE PRATIQUE
Suppression des sous-titres, filigranes et commentaires d’une vidéo : test de huit cas d’occultation
Un logo fixe sur un fond simple est plus facile à supprimer qu’un texte sur un visage ou un tissu. Nous publions les huit résultats contrôlés, y compris les cas où la retouche améliore à peine l’image.
Commencez par le résultat : la difficulté dépend de ce qui est masqué
« Supprimer des sous-titres » ne correspond pas à un seul niveau de difficulté. Il peut s’agir d’une marque fixe dans un coin sur un mur uni, d’un logo sur un visage, d’un texte translucide sur du tissu, de commentaires défilants, de sous-titres sur deux lignes ou d’un texte sur une scène qui change. Le résultat dépend de la présence ou non d’un arrière-plan propre dans d’autres images, de la surface masquée, du déplacement de la superposition et de la texture qui subsiste après la retouche.
Nous avons comparé l’inpainting classique de Telea à la configuration STTN sélectionnée dans le projet au moment du test. Les résultats se sont améliorés sur les fonds unis et les commentaires mobiles peu nombreux. Pour un filigrane difficile recouvrant un visage, le PSNR n’a augmenté que de 0,87 dB et le visage retouché restait visiblement déformé. Le gain n’était que de 1,12 dB pour un texte translucide sur du tissu. Ces échecs figurent dans le tableau : un résultat réussi avec un logo dans un coin ne représente pas toutes les vidéos.
Comment les huit scènes ont été conçues
Les tests contrôlés utilisent les mêmes images d’une interview de DVIDS relevant du domaine public, ramenées à deux secondes et normalisées à 640 × 360 pixels et 24 images par seconde, soit 48 images. Les testeurs ont ajouté des logos synthétiques dans les coins, du texte translucide, des sous-titres et des commentaires défilants sur des images sans retouche. L’image d’origine fournit donc une référence exacte pour les pixels masqués. Le modèle de retouche reçoit les images occultées et un masque, pas l’image sans retouche. Les huit cas sont des variantes d’une même source, et non huit vidéos tournées séparément ni un échantillon des fichiers envoyés par les utilisateurs.
La principale mesure est le PSNR dans la zone masquée synthétiquement. Une valeur plus élevée signifie que les pixels se rapprochent davantage de la référence propre connue. Le gain correspond à la configuration de retouche sélectionnée moins la valeur de référence de Telea. Les cas de sous-titres utilisent STTN avec des masques resserrés autour des glyphes ; les autres cas utilisent STTN. Le PSNR mesure la distance entre les pixels, pas le naturel de l’image aux yeux des personnes qui la regardent. Le tableau principal est calculé avant l’encodage final de la vidéo ; les effets de l’encodage sont présentés séparément.
Les huit cas contrôlés
| Cas synthétique | PSNR de référence Telea | Configuration sélectionnée | Gain | Rappel du masque de superposition |
|---|---|---|---|---|
| Logo graphique fixe · fond uni | 33,87 dB | 41,94 dB | +8,08 dB | 100 % |
| Logo graphique fixe · sur un visage | 11,98 dB | 12,85 dB | +0,87 dB | 100 % |
| Filigrane de texte translucide · fond uni | 36,24 dB | 43,38 dB | +7,15 dB | 100 % |
| Filigrane de texte translucide · texture de tissu | 15,52 dB | 16,64 dB | +1,12 dB | 100 % |
| Commentaires défilants · une ligne simple | 16,49 dB | 33,34 dB | +16,85 dB | 100 % |
| Commentaires défilants · deux lignes sur une personne | 17,44 dB | 28,15 dB | +10,71 dB | 99,92 % |
| Sous-titres incrustés · une ligne simple | 16,44 dB | 22,29 dB | +5,85 dB | 100 % |
| Sous-titres incrustés · cas difficile sur deux lignes | 17,64 dB | 22,17 dB | +4,53 dB | 100 % |
Un PSNR élevé signifie que, dans ces exemples synthétiques, les pixels masqués se rapprochent davantage d’une référence propre. Cela ne garantit pas un résultat visuellement réussi. Dans le cas du logo sur un visage, le rappel du masque était de 100 %, mais les détails du visage étaient visiblement abîmés : détecter tous les pixels de la superposition ne signifie pas les restaurer correctement. La comparaison ci-dessous utilise des images publiques avec un sous-titre synthétique et un résultat réel de retouche dans le navigateur.
Le cas difficile des commentaires défilants a également fait l’objet d’un essai facultatif avec un masque affiné : il a obtenu 24,91 dB et un rappel du masque de 99,60 %, contre 28,15 dB et 99,92 % avec le masque par défaut. Cette variante permet d’étudier le compromis entre une limite plus précise et la similarité des pixels, mais elle ne remplace pas les valeurs du tableau par défaut à huit cas. Ces deux valeurs restent des mesures faites sur une seule scène synthétique.
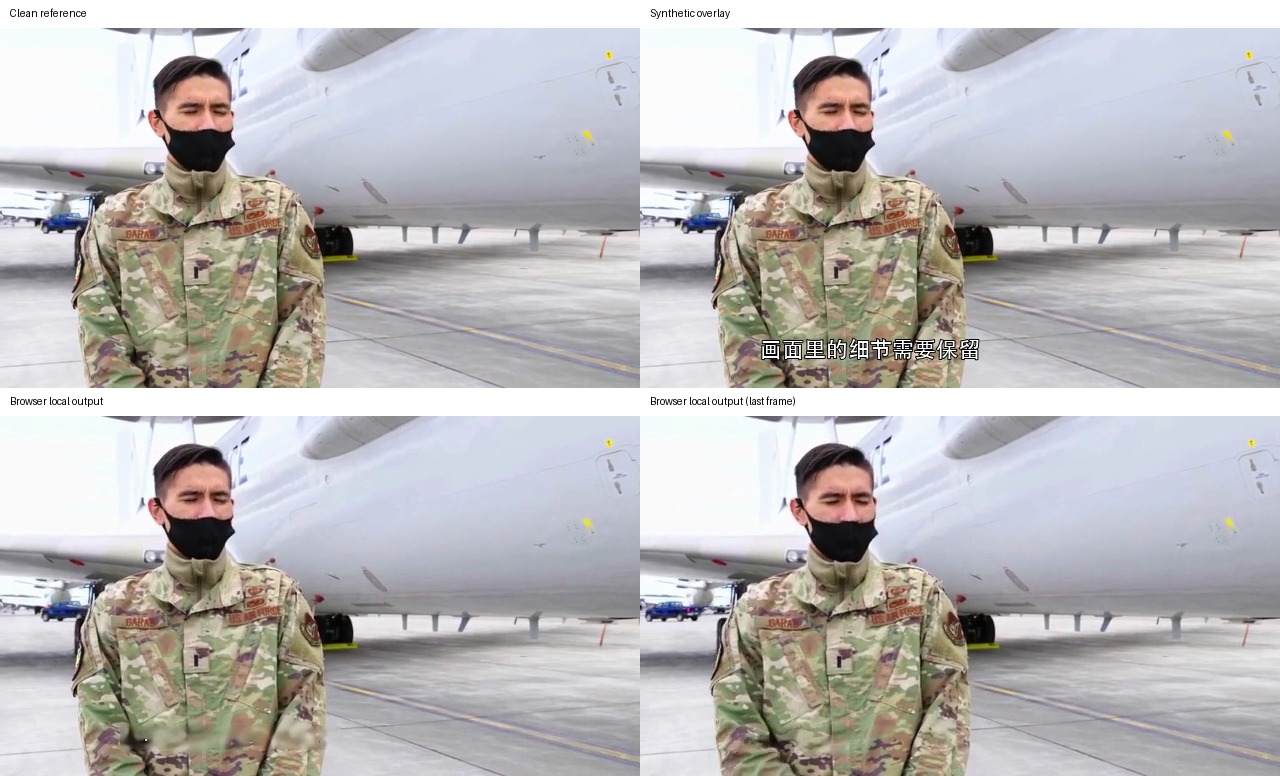
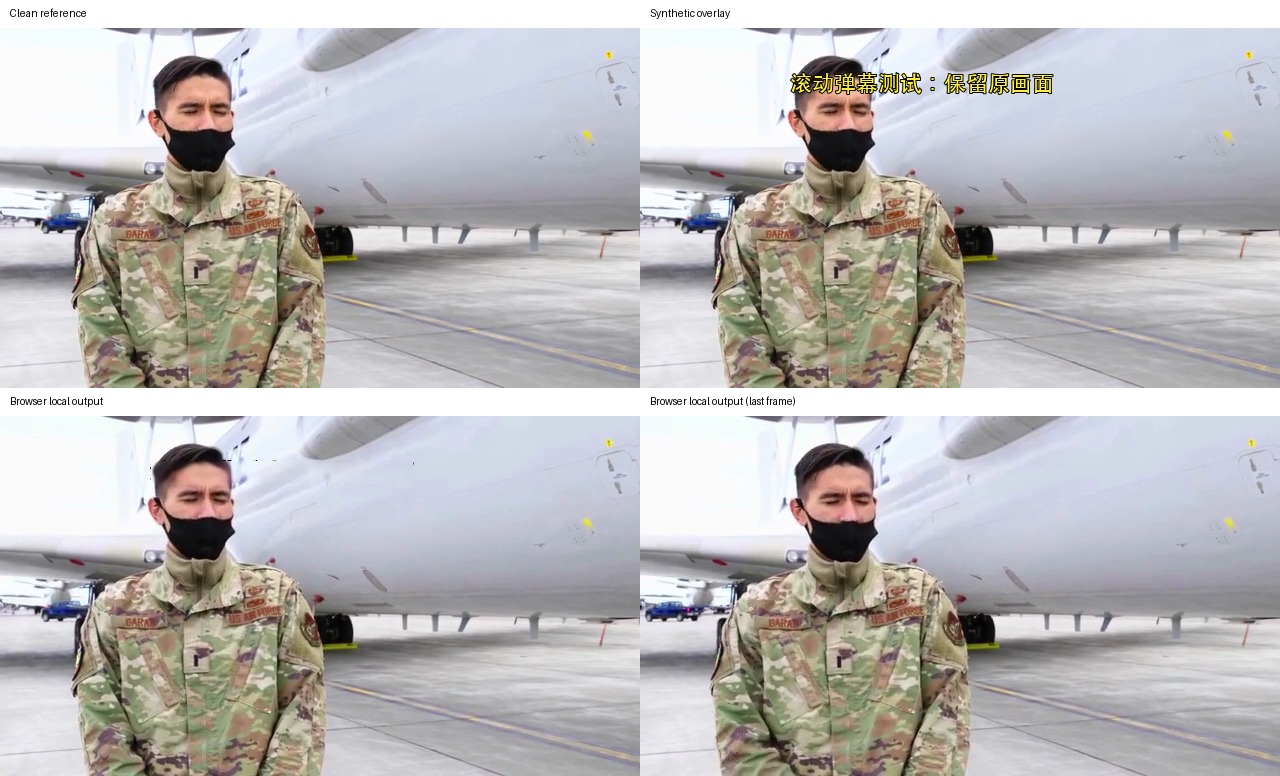
Contre-vérification sur des exports compressés réels du navigateur
Le principal test de référence mesure la sortie du modèle avant l’encodage. Nous avons également exporté quatre entrées de test en MP4 avec le traitement local dans le navigateur de QuietTake, puis mesuré les fichiers décodés ; le rapport ne repose donc pas uniquement sur les tenseurs internes du modèle. Chaque sortie dure deux secondes, fait 640 × 360 pixels et comprend 48 images. La vidéo et l’audio ont été décodés sans erreur, et l’export a conservé sa piste audio. Cet essai a utilisé Chromium WebGPU sur un appareil Apple Silicon avec 16 Gio de mémoire ; le modèle était déjà dans le cache du navigateur. Le téléchargement initial du modèle, d’environ 98,5 Mo dans cette version, n’est pas inclus dans les durées.
| Type | PSNR de la zone masquée après encodage | MAE de la zone masquée (0–255) | MAE hors de la zone | Durée dans le navigateur |
|---|---|---|---|---|
| Logo graphique | 38,58 dB | 2,47 | 2,30 | 23,4 s |
| Filigrane de texte translucide | 30,25 dB | 4,61 | 2,30 | 23,4 s |
| Sous-titres sur deux lignes | 21,99 dB | 14,50 | 2,31 | 20,4 s |
| Commentaires défilants | 24,16 dB | 5,57 | 2,30 | 23,0 s |
Une MAE d’environ 2,3 hors de la zone provient surtout des différences dues à l’encodage H.264. Cela ne signifie pas que le modèle de retouche a régénéré toute l’image. En revanche, les résultats du tableau sur l’algorithme sont mesurés avant encodage, sur les mêmes pixels synthétiques. Les deux tableaux portent sur des étapes différentes et leurs valeurs ne doivent pas être soustraites les unes des autres. La durée dans le navigateur a été mesurée sur cet appareil, pour des échantillons de deux secondes et avec le modèle déjà en cache ; elle ne constitue pas une promesse de traitement en temps réel ni de vitesse universelle.
Les échantillons d’entrée et de sortie, ainsi que les crédits, sont décrits dans la fiche des médias de l’expérience. La vidéo ci-dessus est un MP4 produit par le navigateur ; les images de comparaison présentent côte à côte les images retouchées, les références sans retouche et les superpositions synthétiques.
Pourquoi un bon score peut aboutir à une image abîmée
Un logo fixe sur une surface unie est plus facile à supprimer, car les pixels voisins fournissent au modèle un contexte plausible. Lorsqu’un logo recouvre un visage, les yeux, le nez et les détails de peau masqués peuvent ne jamais apparaître dans une autre image ; le modèle doit alors les estimer. Un PSNR plus élevé sur ce petit échantillon ne restitue pas les véritables traits de la personne. Pour l’actualité, les archives ou les preuves, ne présentez pas les pixels générés comme des faits historiques.
Le texte translucide sur un vêtement est un autre cas difficile. Le filigrane se mélange à la couleur du tissu ; le supprimer modifie donc aussi la texture. Des commentaires mobiles peu nombreux peuvent laisser apparaître l’arrière-plan dans d’autres images. Si les lignes se chevauchent, si une personne bouge rapidement ou si l’arrière-plan change, la retouche peut laisser des fragments ou des traînées, ou provoquer du scintillement. Les sous-titres sur des vêtements, des feuilles ou des motifs fins sont sensibles à la largeur du masque et à la forme des glyphes.
Le rappel du masque repose sur un dénominateur restreint : cette mesure indique quelle part d’une superposition synthétique connue a été couverte par le masque généré. Ici, sa position et sa forme sont contrôlées. Les vrais sous-titres peuvent comporter des contours, des ombres, du bruit de compression et des arrière-plans mobiles. Un rappel de 99,6 % ne signifie pas que « 99,6 % des vidéos des utilisateurs seront corrigées ». Il s’agit du pourcentage de pixels couverts dans cette expérience, pas du taux de réussite du produit.
Comment vérifier votre propre extrait
Commencez par faire une copie et choisissez un passage représentatif d’environ deux à cinq secondes qui contient la superposition difficile à traiter. Incluez du mouvement, un changement de sous-titres ou une coupure de scène si c’est là que le problème se pose. Un aperçu qui ne montre que la première image ne suffit pas si le défaut apparaît à la fin. Vérifiez que la zone sélectionnée n’inclut pas aussi des visages, des panneaux, du texte présent dans la scène ou des objets importants : plus la zone est grande, plus le modèle doit inventer de pixels.
Regardez la vidéo une fois à vitesse normale, puis inspectez la zone retouchée. Mettez en pause pour examiner la texture et les contours du texte ; regardez la vidéo en continu pour repérer les restes, les images fantômes, le scintillement ou les changements brusques de forme. Vérifiez les changements en dehors du masque, notamment sur les visages, les mains, les vêtements et l’arrière-plan. Inspectez la première et la dernière image, puis faites défiler la vidéo jusqu’à des positions aléatoires au lieu de vous limiter à l’image d’aperçu choisie par l’application.
Vérifiez aussi l’audio. L’entrée contrôlée contient une tonalité de test synthétique et les exports du navigateur ont conservé une piste audio décodable. Cela confirme le fonctionnement de la chaîne d’export lors de cet essai ; cela ne garantit pas que tous les navigateurs ou codecs préserveront toutes les bandes-son. Écoutez l’export réel, vérifiez sa durée et la synchronisation labiale, et examinez tout résultat muet inattendu au lieu de déduire le comportement audio à partir d’un aperçu sans son.
Pour reproduire le test de référence de l’algorithme, exécutez le script du projet à huit cas avec les mêmes entrées, références sans retouche et masques d’évaluation. Les résultats bruts et la sortie locale du navigateur sont stockés séparément. Indiquez la configuration du modèle, l’utilisation ou non du resserrement autour des glyphes, la résolution, la fréquence d’images, la méthode de sélection des images de référence et l’étape d’encodage. Ne combinez pas des valeurs PSNR obtenues à différentes étapes. H.264 modifie les pixels décodés ; la MAE après encodage ne remplace donc pas la comparaison du modèle avant encodage.
Le score du test de référence n’est pas un taux de réussite pour les utilisateurs
Le PSNR de la zone recouverte mesure la distance par rapport aux pixels propres connus. Cela fonctionne pour les tests synthétiques avec des références exactes. Les vidéos des utilisateurs contiennent rarement une copie non masquée de chaque image recouverte ; le même score ne peut donc pas être calculé pour les téléversements ordinaires. Un score plus élevé signifie que, dans cette configuration, les pixels se sont rapprochés de la référence. Cela ne garantit ni un mouvement naturel ni la récupération réelle de la scène masquée.
Le rappel du masque a lui aussi son propre dénominateur : la proportion des pixels connus de la superposition qui sont inclus dans un masque. Les emplacements et les formes synthétiques sont contrôlés, tandis que les sous-titres incrustés comportent des contours, des ombres et des artefacts de compression. Ne transformez pas un taux de rappel de 99,6 % en affirmant que « 99,6 % des vidéos sont nettoyées avec succès ». Les questions pratiques sont de savoir s’il reste du texte, si des objets normaux ont été effacés et si la réparation scintille pendant la lecture.
Le temps d’exportation d’un extrait de deux secondes dans le navigateur ne mesure pas la vitesse en temps réel. La tâche complète peut inclure le décodage vidéo, le téléchargement ou la lecture en cache du modèle, la détection du texte, la réparation, l’encodage audio et le téléchargement du résultat. Les téléchargements de première utilisation sont distincts. Le GPU, le pilote, le navigateur, le codec et la mémoire disponible influencent tous la vitesse et les échecs. Les nouveaux tests internes devraient indiquer les exécutions avec cache froid et cache chaud, ainsi que les replis de précision, les images manquantes ou les erreurs du navigateur.
Conseils pratiques pour les créateurs
- Petit logo fixe sur un arrière-plan uni : commencez par un court aperçu et examinez ses contours par rapport à l’image.
- Sous-titres incrustés ou commentaires espacés : vérifiez les changements de ligne, les mouvements du sujet et les changements de scène pendant tout l’intervalle.
- Marques sur un visage, un tissu ou un objet important : vérifiez si les détails sous-jacents sont déformés ; conservez l’original si les détails générés sont inacceptables.
- Piste de sous-titres distincte ou commentaires du lecteur : désactivez ou supprimez d’abord cette couche ; reconstruire les pixels de l’image est inutile et peut réduire la qualité.
- Interviews, actualités et archives : conservez la source, indiquez que la copie réparée a été modifiée et ne présentez pas l’arrière-plan généré comme l’enregistrement original.
Dans l’effaceur vidéo, prévisualisez un court intervalle qui comprend la partie la plus difficile. Examinez les contours, les personnes, les mouvements et la bande sonore avant l’exportation. De bons résultats sur des marques fixes simples ne permettent pas de prédire les résultats dans les cas difficiles concernant les visages et les tissus de ce test.
Méthode et limites
L’étude de huit cas utilise Python et OpenCV pour l’évaluation des pixels, ainsi que de véritables exportations locales dans le navigateur Chromium. Les métriques sont calculées dans des zones de masques synthétiques par rapport à des images de référence propres ; la MAE correspond à l’erreur absolue moyenne par canal. L’ensemble de réparations utilise une seule interview appartenant au domaine public comme source de base, avec des superpositions synthétiques. Il ne couvre pas tous les plans, toutes les polices, toutes les résolutions, les vidéos en mode portrait, le HDR ni les commentaires denses défilant sur tout l’écran.
L’exécution dans le navigateur a utilisé Chromium WebGPU sur Apple Silicon avec 16 Gio de mémoire. Un décodage réussi prouve que les fichiers sont lisibles sur le plan structurel, mais pas que chaque image soit parfaite. Les fichiers du modèle étaient déjà en cache ; la première utilisation nécessite un téléchargement plus important. Un GPU, un navigateur, un pilote ou un codec d’entrée différent peut modifier la vitesse ou provoquer un échec.
Ces tests ne constituent pas une estimation du taux de réussite pour n’importe quel fichier téléversé aujourd’hui et ne garantissent pas la récupération réelle de l’image masquée. Les superpositions denses et les détails humains doivent tout de même être vérifiés. Si les détails de scène générés risquent d’être plus trompeurs que le maintien d’une marque visible, conservez la source ou interrompez la réparation.