Test del prodotto · Rimozione oggetti dal video · GUIDA PRATICA
Rimozione di sottotitoli, filigrane e commenti dai video: test su otto casi di occlusione
Un logo fisso su uno sfondo semplice è più facile da rimuovere rispetto a un testo sul volto o su un tessuto. Pubblichiamo tutti e otto i risultati controllati, compresi i casi in cui la correzione ha migliorato a malapena l’immagine.
Parti dal risultato: il contenuto coperto determina la difficoltà
«Rimuovere i sottotitoli» non corrisponde a un unico livello di difficoltà. Può significare rimuovere un logo fisso nell’angolo su una parete uniforme, un logo sopra un volto, un testo traslucido su un tessuto, commenti a scorrimento, sottotitoli su due righe oppure testo su una scena in movimento. Il risultato dipende dalla presenza dello sfondo pulito in altri fotogrammi, dall’area coperta, dal movimento della sovrapposizione e dalla texture originale che resta dopo la correzione.
Abbiamo confrontato il riempimento di Telea tradizionale con la configurazione STTN selezionata nel progetto al momento del test. I risultati sono migliorati sugli sfondi uniformi e con i commenti in movimento più radi. Nel caso difficile di una filigrana che copriva un volto, il PSNR è migliorato di appena 0,87 dB e il volto corretto era ancora visibilmente distorto. Il testo traslucido su tessuto è migliorato di appena 1,12 dB. Questi casi problematici restano nella tabella: un risultato convincente con un logo nell’angolo non rappresenta tutti i video.
Come sono state costruite le otto scene
I test controllati usano la stessa ripresa di un’intervista DVIDS di pubblico dominio, tagliata a due secondi e normalizzata a 640 per 360 pixel a 24 fps, ovvero 48 fotogrammi. I tester hanno aggiunto loghi sintetici negli angoli, testo traslucido, didascalie e commenti a scorrimento sopra fotogrammi puliti. L’immagine originale fornisce quindi un riferimento esatto per i pixel coperti. Il modello di riparazione riceve i fotogrammi coperti e una maschera, non l’immagine pulita. Gli otto casi sono variazioni di un’unica fonte, non otto video girati separatamente né un campione dei caricamenti degli utenti.
La metrica principale è il PSNR all’interno della zona coperta sintetica. Valori più alti indicano che i pixel sono più vicini al riferimento pulito noto. Il guadagno è la differenza tra la configurazione di correzione selezionata e il risultato di base di Telea. Nei casi con sottotitoli si usa STTN con maschere adattate alla forma dei caratteri; negli altri casi si usa STTN. Il PSNR misura la distanza tra i pixel, non quanto l’immagine sembri naturale agli spettatori. La tabella principale valuta i risultati prima della codifica video; gli effetti della codifica sono riportati separatamente.
Tutti e otto i casi controllati
| Caso sintetico | PSNR di base Telea | Configurazione selezionata | Guadagno | Richiamo della maschera di sovrapposizione |
|---|---|---|---|---|
| Logo grafico fisso · sfondo uniforme | 33,87 dB | 41,94 dB | +8,08 dB | 100% |
| Logo grafico fisso · sopra un volto | 11,98 dB | 12,85 dB | +0,87 dB | 100% |
| Filigrana con testo traslucido · sfondo uniforme | 36,24 dB | 43,38 dB | +7,15 dB | 100% |
| Filigrana con testo traslucido · texture di tessuto | 15,52 dB | 16,64 dB | +1,12 dB | 100% |
| Commenti a scorrimento · una riga semplice | 16,49 dB | 33,34 dB | +16,85 dB | 100% |
| Commenti a scorrimento · due righe sopra una persona | 17,44 dB | 28,15 dB | +10,71 dB | 99,92% |
| Sottotitoli incorporati nel video · una riga semplice | 16,44 dB | 22,29 dB | +5,85 dB | 100% |
| Sottotitoli incorporati nel video · caso difficile su due righe | 17,64 dB | 22,17 dB | +4,53 dB | 100% |
Un PSNR elevato indica che, in questi esempi sintetici, i pixel coperti erano più vicini a un riferimento pulito. Non garantisce un risultato visivamente convincente. Il caso del logo sul volto ha raggiunto un richiamo della maschera del 100%, ma i dettagli del viso erano visibilmente danneggiati: rilevare tutti i pixel della sovrapposizione non significa ripristinarli correttamente. Il confronto qui sotto usa riprese pubbliche con una didascalia sintetica e il risultato effettivo della correzione eseguita nel browser.
Anche il caso difficile dei commenti a scorrimento è stato testato con un’opzione di maschera perfezionata: ha ottenuto 24,91 dB con un richiamo della maschera del 99,60%, rispetto a 28,15 dB e al 99,92% della maschera predefinita. Questa variante è utile per studiare il compromesso tra un contorno più preciso e la somiglianza dei pixel, ma non sostituisce il caso predefinito nella tabella degli otto test. Entrambi i valori sono misurazioni su un’unica scena sintetica.
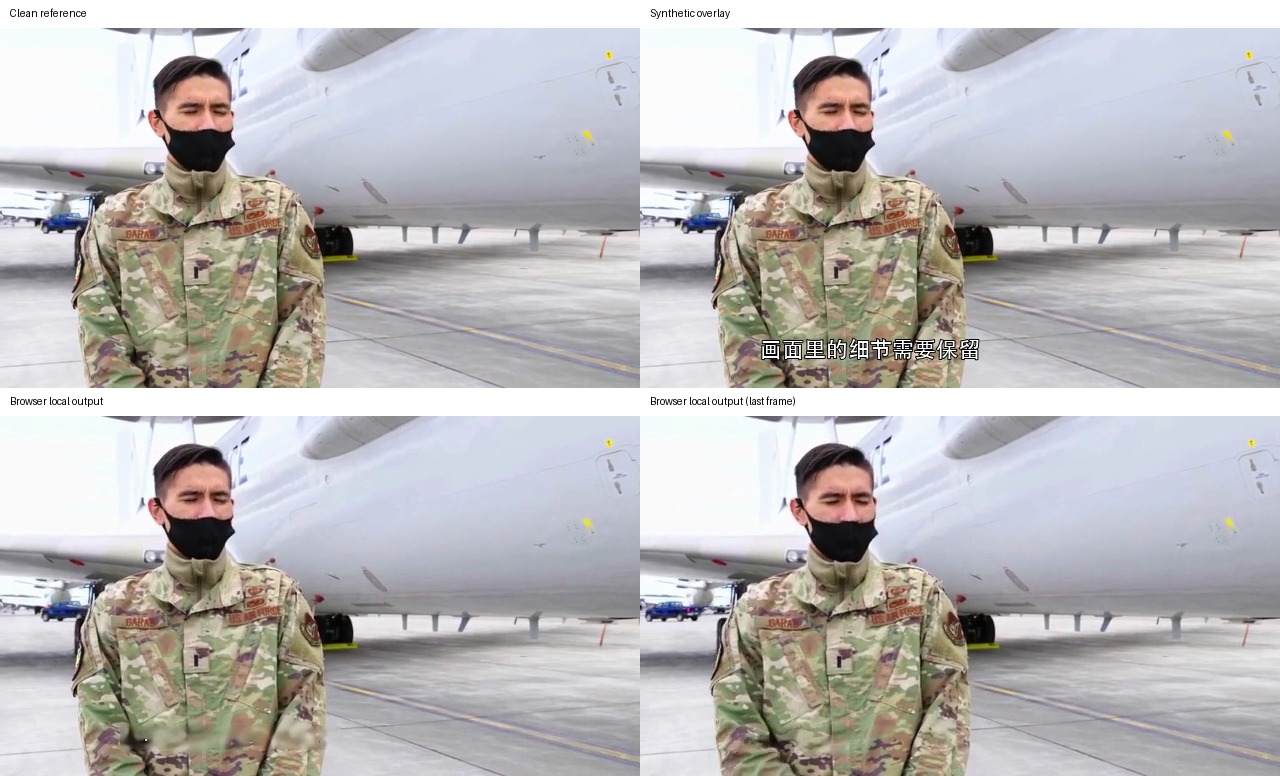
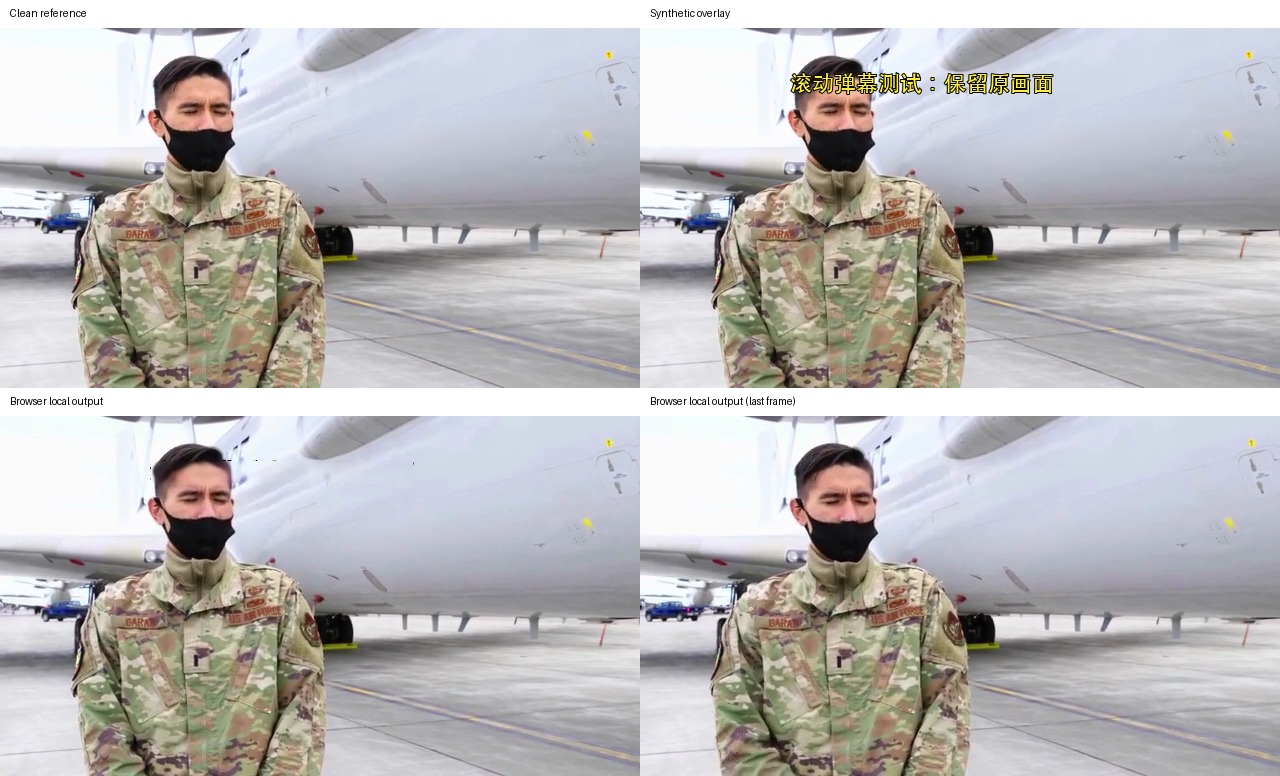
Verifica delle esportazioni compresse dal flusso reale nel browser
Il benchmark principale misura l’output del modello prima della codifica. Abbiamo anche esportato quattro input di test in MP4 tramite il flusso di lavoro locale di QuietTake nel browser e misurato i file decodificati, così il rapporto non si basa solo sui tensori interni del modello. Ogni output dura due secondi, ha una risoluzione di 640 per 360 e contiene 48 fotogrammi. Video e audio sono stati decodificati correttamente e l’esportazione ha mantenuto la traccia audio. Il test è stato eseguito con Chromium WebGPU su un dispositivo Apple Silicon con 16 GiB di memoria, con il modello già nella cache del browser. Il download iniziale del modello, di circa 98,5 MB in questa versione, non è incluso nei tempi.
| Tipo | PSNR della zona coperta dopo la codifica | MAE della zona coperta (0–255) | MAE al di fuori della zona | Tempo trascorso nel browser |
|---|---|---|---|---|
| Logo grafico | 38,58 dB | 2,47 | 2,30 | 23,4 s |
| Filigrana con testo traslucido | 30,25 dB | 4,61 | 2,30 | 23,4 s |
| Sottotitoli su due righe | 21,99 dB | 14,50 | 2,31 | 20,4 s |
| Commenti a scorrimento | 24,16 dB | 5,57 | 2,30 | 23,0 s |
La MAE di circa 2,3 al di fuori della zona interessata dipende in gran parte dalle differenze di codifica H.264. Non significa che il modello di riparazione abbia rigenerato l’intero fotogramma. Al contrario, la tabella dell’algoritmo è misurata prima della codifica sugli stessi pixel sintetici. Le due tabelle si riferiscono a fasi diverse e i valori non vanno sottratti tra loro. I tempi nel browser riguardano questo dispositivo, i campioni di due secondi e una cache del modello già caricata; non costituiscono una promessa di velocità in tempo reale o universale.
Gli input, gli output di esempio e le attribuzioni sono descritti nella scheda dei contenuti multimediali dell’esperimento. Il video qui sopra è un MP4 prodotto nel browser; le immagini di confronto affiancano i fotogrammi corretti ai riferimenti puliti e alle sovrapposizioni sintetiche.
Perché un buon punteggio può coincidere con un’immagine danneggiata
Un logo fisso su una superficie uniforme è più facile da rimuovere perché i pixel vicini forniscono al modello un contesto plausibile. Quando un logo copre un volto, gli occhi, il naso e i dettagli della pelle nascosti potrebbero non apparire mai in un altro fotogramma; il modello deve stimarli. Un PSNR più alto su questo piccolo campione non ripristina i dettagli reali dell’identità. Per notizie, archivi o prove, non presentare i pixel generati come fatti storici.
Anche il testo traslucido sui vestiti è un caso difficile. La scritta si mescola al colore del tessuto, quindi rimuoverlo modifica anche la texture. I commenti in movimento più radi possono lasciare intravedere lo sfondo in altri fotogrammi. Se le righe si sovrappongono, una persona si muove rapidamente o lo sfondo cambia, la correzione può lasciare frammenti, scie o sfarfallio. I sottotitoli su vestiti, foglie o motivi minuti sono sensibili alla larghezza della maschera e alla forma dei caratteri.
Il richiamo della maschera ha un denominatore limitato: misura quale parte di una sovrapposizione sintetica nota è stata coperta dalla maschera generata. In questo test, posizione e forma sono controllate. Le didascalie reali presentano contorni, ombre, artefatti di compressione e sfondi in movimento. Un richiamo del 99,6% non significa che «il 99,6% dei video degli utenti verrà corretto». In questo esperimento si misura la copertura dei pixel, non il tasso di successo del prodotto.
Come controllare una tua clip
Parti da una copia e scegli un intervallo rappresentativo, di circa due-cinque secondi, che contenga la sovrapposizione difficile da rimuovere. Includi un movimento, un cambio di sottotitoli o uno stacco di scena, se è in quel punto che si verifica il problema. Un’anteprima che mostra solo il primo fotogramma non basta quando il difetto si presenta alla fine. Verifica che la regione selezionata non includa anche volti, cartelli, testo normale della scena o oggetti importanti: più ampia è la regione, più pixel il modello deve inventare.
Guarda il video una volta a velocità normale, poi esamina la zona corretta. Metti in pausa per controllare texture e contorni del testo; riproducilo senza interruzioni per individuare residui, immagini fantasma, sfarfallio o cambiamenti improvvisi di forma. Controlla che al di fuori della maschera non siano cambiati volti, mani, vestiti o sfondo. Esamina il primo e l’ultimo fotogramma, poi passa a punti casuali invece di controllare solo il fotogramma di anteprima selezionato dall’app.
Controlla anche l’audio. L’input controllato contiene un tono di test sintetico e le esportazioni dal browser hanno mantenuto una traccia audio decodificabile. Questo conferma il funzionamento della pipeline di output in questo test, ma non garantisce che ogni browser o codec conservi ogni colonna sonora. Riproduci l’esportazione effettiva, controlla la durata e la sincronizzazione labiale, e verifica un eventuale risultato inaspettatamente silenzioso invece di dedurre il comportamento dell’audio da un’anteprima senza suono.
Per riprodurre il benchmark dell’algoritmo, esegui lo script del progetto per gli otto casi usando gli stessi input, riferimenti puliti e maschere di valutazione. I risultati grezzi e l’output elaborato localmente nel browser sono archiviati separatamente. Indica la configurazione del modello, se è stato usato l’adattamento alle forme dei caratteri, la risoluzione, la frequenza dei fotogrammi, la strategia per i fotogrammi di riferimento e la fase di codifica. Non combinare valori PSNR misurati in fasi diverse. H.264 modifica i pixel decodificati, quindi la MAE dopo la codifica non sostituisce il confronto del modello prima della codifica.
Il punteggio del benchmark non è un tasso di successo per gli utenti
Il PSNR delle aree coperte misura la distanza dai pixel puliti noti. È utile nei test sintetici con riferimenti esatti. Nei video degli utenti, di rado è disponibile una copia non coperta di ogni fotogramma, quindi non è possibile calcolare lo stesso punteggio per i normali caricamenti. In questa configurazione, un punteggio più alto significa che i pixel si sono avvicinati al riferimento. Non garantisce un movimento naturale né il recupero della vera scena nascosta.
Anche il richiamo della maschera ha il proprio denominatore: la percentuale di pixel noti della sovrimpressione inclusi nella maschera. Nei test sintetici, posizione e forma sono controllate, mentre i sottotitoli reali presentano artefatti dovuti a contorni, ombre e compressione. Non interpretare un valore di richiamo del 99,6% come l’affermazione che «il 99,6% dei video viene ripulito correttamente». Le domande pratiche sono: resta del testo? Sono stati cancellati oggetti normali? La riparazione sfarfalla durante la riproduzione?
Il tempo di esportazione nel browser di un campione di due secondi non misura la velocità in tempo reale. L’intera operazione può includere la decodifica del video, il download o la lettura dalla cache del modello, il rilevamento del testo, la riparazione, la codifica dell’audio e il download del risultato. I download necessari al primo utilizzo vanno considerati a parte. GPU, driver, browser, codec e memoria disponibile influiscono sulla velocità e sugli errori. Nei nuovi test interni, registra sia le esecuzioni con cache vuota sia quelle con cache popolata, indicando eventuali ripieghi sulla precisione, fotogrammi mancanti o errori del browser.
Consigli pratici per chi crea contenuti
- Logo piccolo e fisso su uno sfondo uniforme: inizia con un’anteprima breve e controlla i bordi rispetto all’immagine.
- Sottotitoli incorporati nel video o commenti sporadici: controlla i cambi di riga, i movimenti dei soggetti e i cambi di scena per tutto l’intervallo.
- Segni su un volto, un tessuto o un oggetto importante: controlla se i dettagli sottostanti sono distorti; conserva l’originale se i dettagli generati non sono accettabili.
- Traccia di sottotitoli separata o commenti del lettore: disattiva o rimuovi prima quel livello; ricostruire i pixel dell’immagine non è necessario e può ridurne la qualità.
- Interviste, notiziari e archivi: conserva l’originale, indica che la copia riparata è stata modificata e non presentare lo sfondo generato come parte della registrazione originale.
Nello strumento Rimozione oggetti dal video, visualizza in anteprima un breve intervallo che includa la parte più difficile. Controlla i bordi, le persone, il movimento e la traccia audio prima di esportare. Buoni risultati con segni semplici e fissi non permettono di prevedere il risultato nei casi difficili con volti e tessuti di questo test.
Metodo e limiti
Lo studio sugli otto casi usa Python e OpenCV per valutare i pixel, oltre a esportazioni effettive eseguite in locale con Chromium. Le metriche sono calcolate nelle aree coperte da maschere sintetiche e confrontate con fotogrammi di riferimento puliti; MAE indica l’errore assoluto medio per canale. Il gruppo di riparazioni usa una sola intervista di pubblico dominio come fonte di base, a cui sono state aggiunte sovrimpressioni sintetiche. Non include tutti i tipi di inquadratura, carattere, risoluzione, video verticale, HDR o commenti a scorrimento densi a schermo intero.
L’esecuzione nel browser ha usato Chromium WebGPU su Apple Silicon con 16 GiB di memoria. La decodifica riuscita dimostra che i file sono leggibili a livello strutturale, non che ogni fotogramma sia perfetto. I file del modello erano già nella cache; al primo utilizzo è necessario un download più grande. GPU, browser, driver e codec del file possono cambiare la velocità o causare errori.
Questi test non stimano la percentuale di successo sui caricamenti arbitrari attuali e non garantiscono il recupero dell’immagine originale nascosta. Le sovrimpressioni dense e i dettagli delle persone richiedono comunque una verifica. Se i dettagli della scena generati risultano più fuorvianti di un segno visibile, conserva l’originale o interrompi la riparazione.